LLM
全图 · LLM 主线 29 / 113 篇已发
从语言建模到真实系统,14 章 113 篇,沿具体问题理解机制、例子与工程取舍
一、语言建模
7 / 7
二、表示与分词
9 / 9
三、Transformer 架构
10 / 10
- 17 一个 Transformer Block 的「最小骨架」
- 18 归一化的选择:LayerNorm → RMSNorm,Pre-LN vs Post-LN
- 19 训练是并行的:Teacher Forcing 与 Causal Mask
- 20 Attention 在算什么:Q/K/V、Softmax 与 O(N²)
- 21 多头注意力的现代变体:MHA → MQA/GQA → MLA
- 22 推理是串行的:Prefill 与 Decode 的两阶段
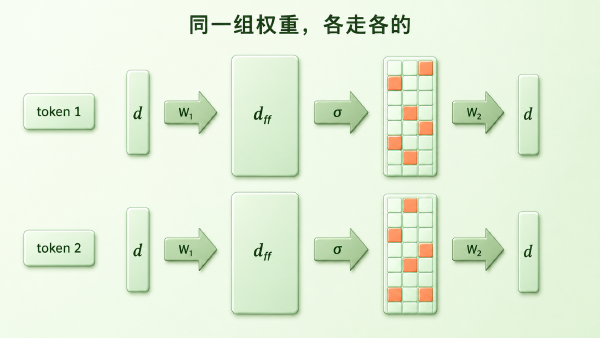
- 23 FFN/MLP 子层:容量来源与「事实记忆」的直觉
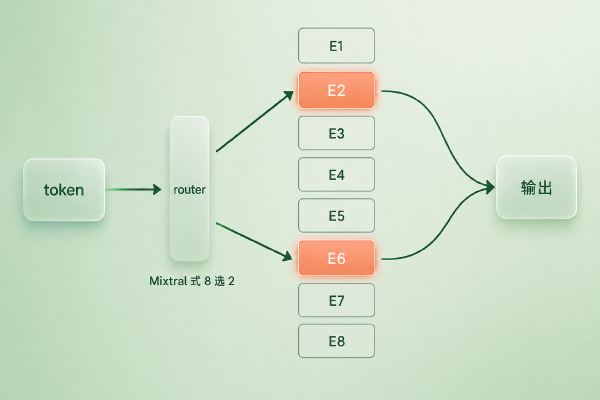
- 24 MoE(Mixture of Experts):稀疏激活与路由策略
- 25 KV Cache:增量复用的本质
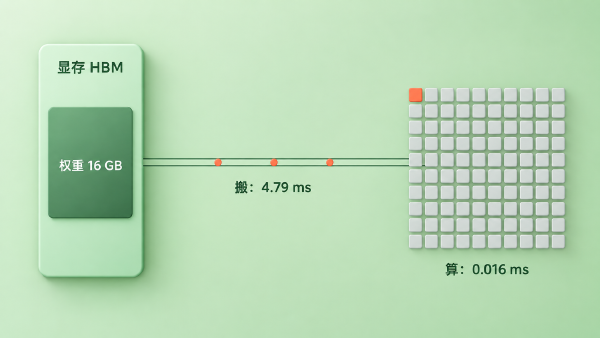
- 26 训练 vs 推理的成本结构:计算密集 vs 访存密集
五、训练与规模
0 / 14
六、评测基础
0 / 4
七、后训练与适配
0 / 10
八、推理能力与计算预算
0 / 7
九、提示与上下文
0 / 5
十、检索增强
0 / 9
十一、工具与 Agent
0 / 8
十二、多模态接口
0 / 4
十三、推理服务
0 / 12
十四、系统选择与迭代
0 / 4
2026


25 KV Cache:增量复用的本质
·7588 字·16 分钟