18 归一化的选择:LayerNorm → RMSNorm,Pre-LN vs Post-LN2026-07-27·7936 字·16 分钟LLM LLM 归一化 LayerNorm RMSNorm Pre-Norm 残差流 训练稳定性 Transformer
论文里程碑 #11:Distributed Representations of Words and Phrases and Their Compositionality2026-07-19·4950 字·10 分钟LLM LLM 论文里程碑 Word2Vec 负采样 子采样 词向量 Skip-Gram Mikolov
17 一个 Transformer Block 的「最小骨架」2026-07-19·5024 字·11 分钟LLM LLM Transformer Decoder-Only 残差连接 归一化 Pre-Norm FFN 注意力
论文里程碑 #10:Efficient Estimation of Word Representations in Vector Space2026-07-12·4873 字·10 分钟LLM LLM 论文里程碑 Word2Vec 词向量 Skip-Gram CBOW 词类比 Mikolov
16 位置编码进化史:从正弦波到 RoPE 旋转位置编码2026-07-12·5803 字·12 分钟LLM LLM 位置编码 RoPE 旋转位置编码 正弦编码 相对位置 Self-Attention Transformer
论文里程碑 #9:Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation2026-07-03·4773 字·10 分钟LLM LLM 论文里程碑 GRU Encoder-Decoder Seq2Seq 机器翻译 RNN Cho
15 Weight Tying:输入输出的镜像关系2026-07-03·4482 字·9 分钟LLM LLM Weight Tying 权重绑定 Embedding Logits Softmax 参数量 输出层
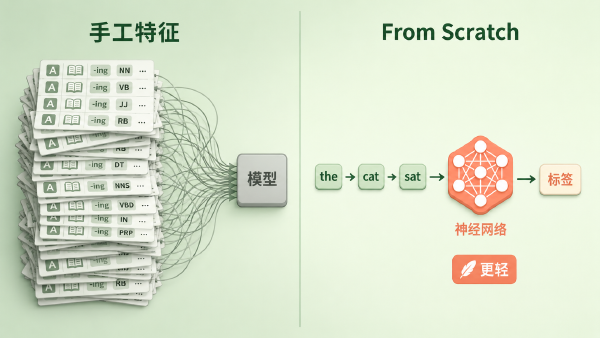
论文里程碑 #8:Natural Language Processing (Almost) from Scratch2026-06-27·4362 字·9 分钟LLM LLM 论文里程碑 NLP 词向量 预训练 SENNA Collobert 特征工程
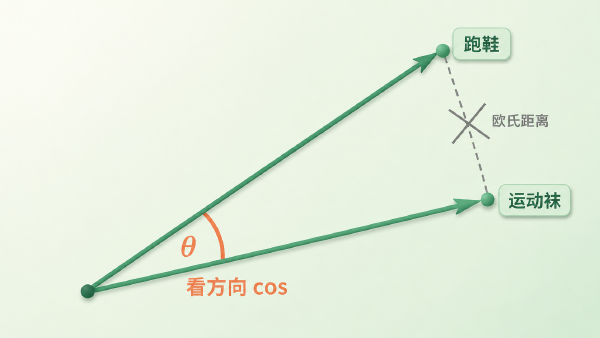
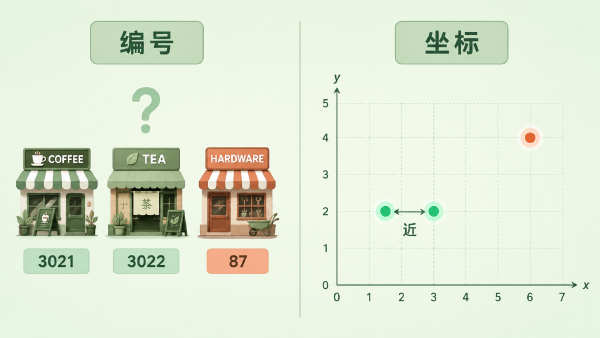
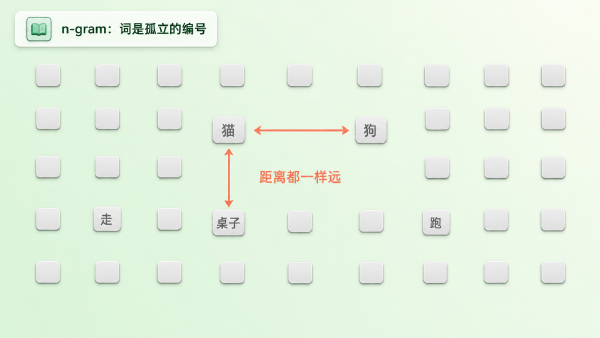
13 Embedding 查表:离散 ID 到连续语义的惊险一跃2026-06-23·5079 字·11 分钟LLM LLM Embedding 词嵌入 查找表 One-Hot 分布式表示 向量空间 Hidden State
论文里程碑 #7:A Neural Probabilistic Language Model2026-06-17·4227 字·9 分钟LLM LLM 论文里程碑 词嵌入 Word Embedding 神经语言模型 Bengio 维度灾难 NLP
论文里程碑 #6:Latent Dirichlet Allocation2026-06-14·4336 字·9 分钟LLM LLM 论文里程碑 主题模型 LDA Topic Model 贝叶斯生成模型 无监督学习 NLP